/ AI-Multiplied Engineering
Gespräch vereinbaren
03 /
Case Studies
CASES / BI · BIG DATA · INFORMATIONSTECHNOLOGIE · GESELLSCHAFT
Demografische Big-Data-Verarbeitung
Fragmentierte öffentliche US-Daten – gesammelt, verarbeitet und nutzbar gemacht.
USA · ÖFFENTLICHE DATEN
BI, Big Data, GESELLSCHAFT, INFORMATIONSTECHNOLOGIE
BRANCHE
Verarbeitung öffentlicher Daten
STANDORT
USA
DAUER
16 months
Cloud
AWS
I
— ÜBER DEN KUNDEN

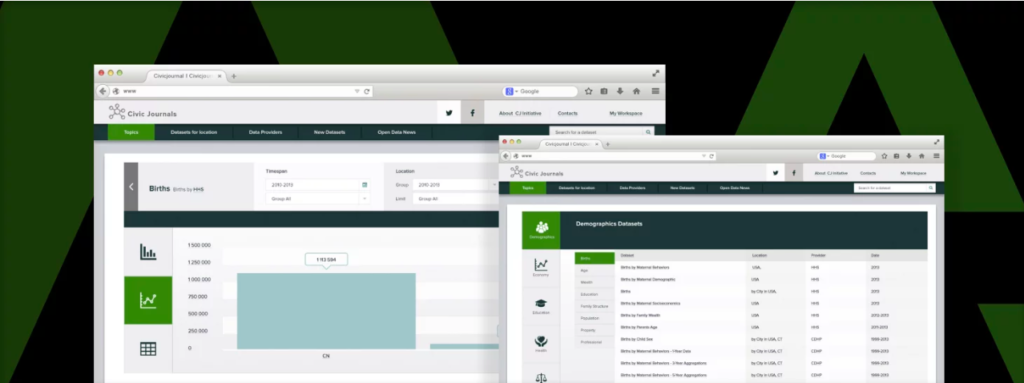
Eine US-Non-Profit-Organisation, die eine Plattform zur Sammlung und Analyse öffentlicher Daten von Behörden und anderen Institutionen aufbaut.
II · DIE AUFGABE
— HERAUSFORDERUNG
Kontext

Öffentliche Daten liegen verstreut in inkompatiblen Formaten vor und sind im großen Maßstab schwer nutzbar. Das System musste zuverlässig und mit minimalem Betriebsaufwand laufen.

— ZENTRALE ZIELE
01
Daten aus APIs, Fileservern, HTML-Seiten und PDFs einlesen
02
Skalieren, ohne die Infrastrukturkosten deutlich zu erhöhen
03
Schnelle Ergebnisse liefern und im Hintergrund vollständig präzise Daten verarbeiten
04
Kontinuierlich laufen, mit minimalem manuellem Eingriff
II
III · UNSER ANSATZ
— LÖSUNG

Wir haben die Plattform auf AWS gebaut – mit einer hybriden MapReduce-/Lambda-Architektur-Pipeline: schnelle Vorschauen aus dem einen Zweig, vollständig präzise Ergebnisse aus dem anderen – mit modularen Fetchern pro Datenquellentyp und transparentem Wechsel zwischen Hot- und Cold-Storage.
III
IV · DAS ERGEBNIS
— ERGEBNISSE

Die Plattform verarbeitet große, heterogene öffentliche Datensätze mit minimalem Betriebsaufwand. Sie dient Privatpersonen, Forschern und Unternehmen für Planung und Entscheidungsfindung.

01
Cloud
AWS
02
DAUER
16 months
03
BETRIEBSAUFWAND
minimal
04
NUTZER
Privatpersonen · Forschende · Unternehmen
VI
Kontakt
Machen wir Ihre Daten verständlich.
Erzählen Sie uns von Ihren Datenmengen und Zielen. Wir bauen die Pipeline, die sie bewältigt.
Gespräch vereinbaren →
Aterise Booking Assistant
Privacy Notice